SQL braucht automatisches Failover? Failovergruppe konfigurieren
Deine Datenbank hat eine Kopie in einer anderen Region. Bei einem Ausfall muss aber jemand diese zur primären machen und die Serveradresse der Anwendung ändern. Eine Failovergruppe ergänzt einen stabilen Verbindungsnamen, der der primären Datenbank folgt, sowie eine Richtlinie dafür, wer das Failover auslöst. Microsoft managed überträgt das regionale Katastrophen-Failover an Azure.
Beide Server vorbereiten
Verwende das Paar aus Georeplikation aktivieren: sqldb-cloudtrips auf sql-ctappweu in West Europe und die sekundäre Datenbank auf sql-ctappfrc in France Central. Falls eine fehlt, schließe zuerst diesen Trip ab.
Prüfe eine funktionierende Replikation sowie übereinstimmende Dienstebenen, Compute-Ebenen und Rechengrößen. Erlaube deine aktuelle öffentliche IP auf beiden Servern. Verwende für dieses Lab mit SQL-Authentifizierung ctadmin mit demselben Passwort auf beiden Servern; passe es bei Bedarf über Reset password am Server an. So funktionieren dieselben Zugangsdaten nach dem Failover.
Gruppe erstellen
Öffne den Server sql-ctappweu → Data management → Failover groups → Add group. Konfiguriere:
Failover group name: fog-ctsql (weltweit eindeutig)
Secondary server: sql-ctappfrc
Database: sqldb-cloudtrips
Read/write failover policy: Microsoft managed (Automatic)
Grace period: 1 hour
Wähle die Datenbank über Configure database und erstelle die Gruppe. Falls dein Portal die Richtlinie erst danach anbietet, öffne Edit configuration der erstellten Gruppe, setze sie dort und speichere. Verwende einen eigenen Gruppennamen, falls fog-ctsql vergeben ist.
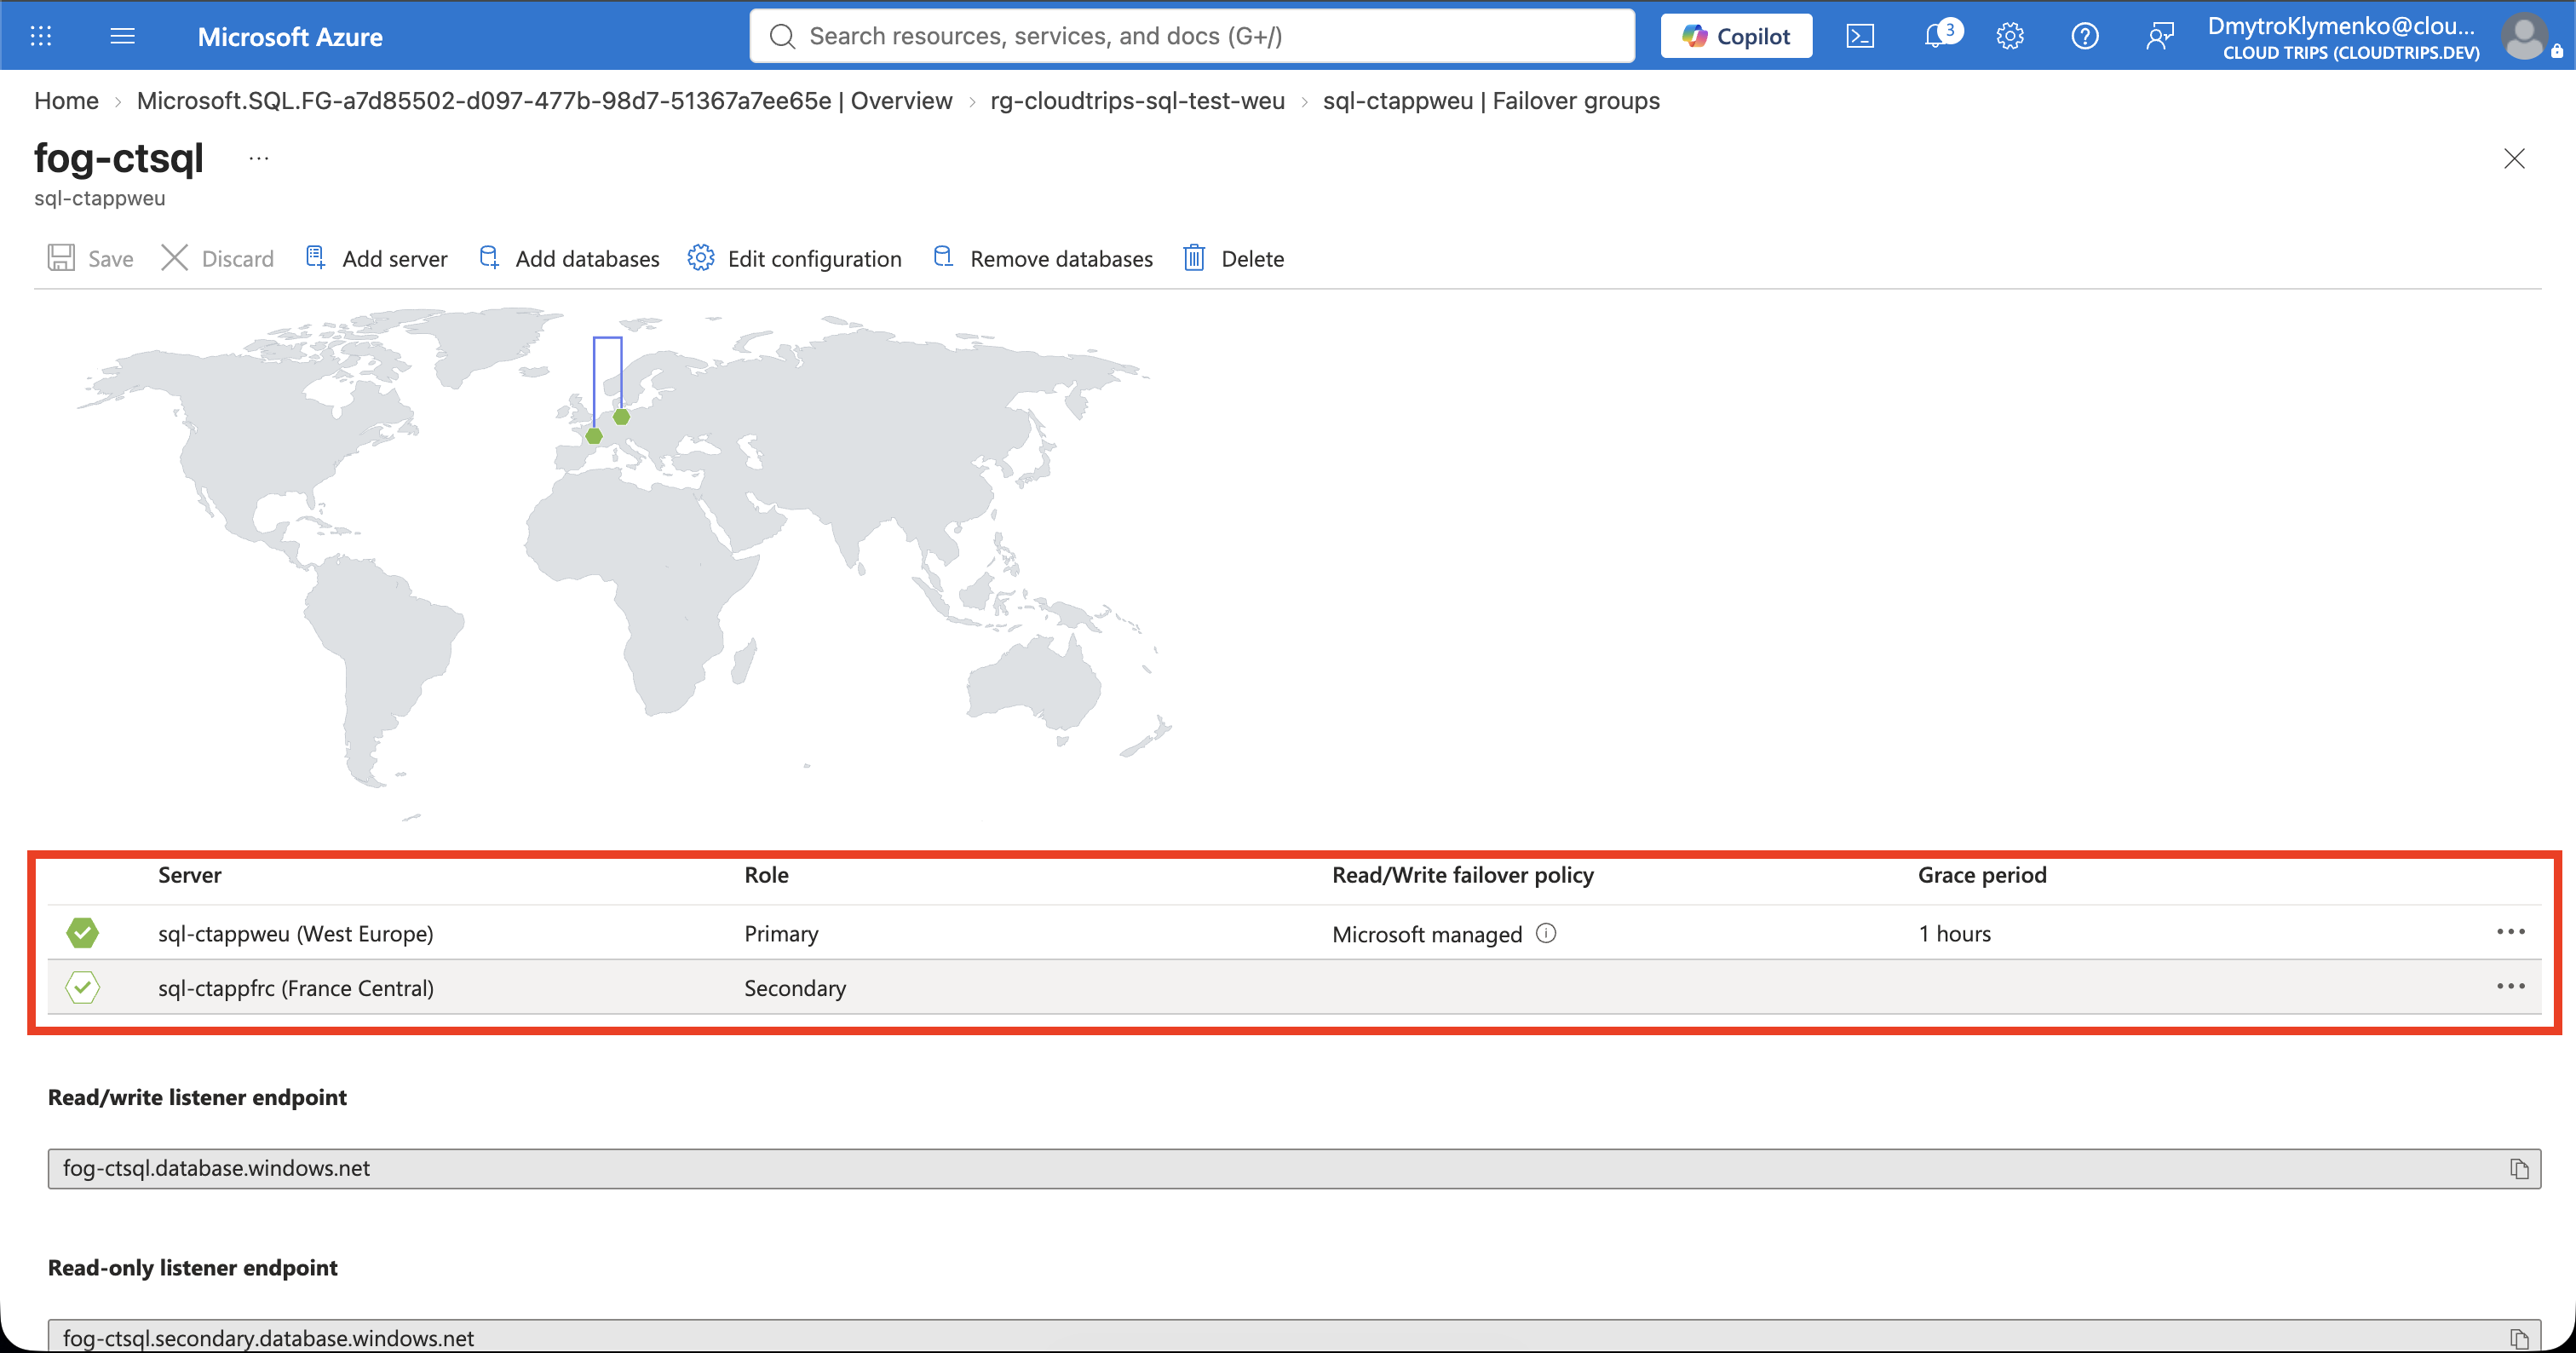
Prüfe Partnerserver, Datenbank, Richtlinie und Wartezeit. Die Gruppe übernimmt die vorhandene Georeplikationsbeziehung.
Eine Stunde ist die Mindestwartezeit, keine garantierte Wiederherstellungszeit. Microsoft-managed-Failover gilt für großflächige regionale Ausfälle; Microsoft entscheidet über den Auslösezeitpunkt. Erzwungenes Failover kann noch nicht replizierte Änderungen verlieren. Für kürzere Wiederherstellungsziele empfiehlt Microsoft kundengesteuertes Failover mit eigener Überwachung und Wiederherstellungsabläufen.
Über die Gruppe verbinden
Der Read/write listener endpoint ist eine feste Serveradresse, die Verbindungen zur aktuellen primären Datenbank leitet. Dort kannst du Daten lesen und ändern. Vor dem Failover zeigt sie auf West Europe, danach auf France Central. Deine Anwendung behält dieselbe Adresse und verbindet sich nach dem Wechsel erneut.
Übernimm den Read/write listener endpoint der Gruppe in eine neue SQL-Verbindung in VS Code:
Server: fog-ctsql.database.windows.net
Database: sqldb-cloudtrips
Authentication: SQL Login
User: ctadmin
Encrypt: Mandatory
Trust server certificate: False
Verwende deinen tatsächlichen Gruppennamen und dein Passwort. Führe aus:
SELECT CONVERT(nvarchar(128), SERVERPROPERTY('ServerName')) AS ConnectedServer,
       DB_NAME() AS DatabaseName,
       DATABASEPROPERTYEX(DB_NAME(), 'Updateability') AS AccessMode;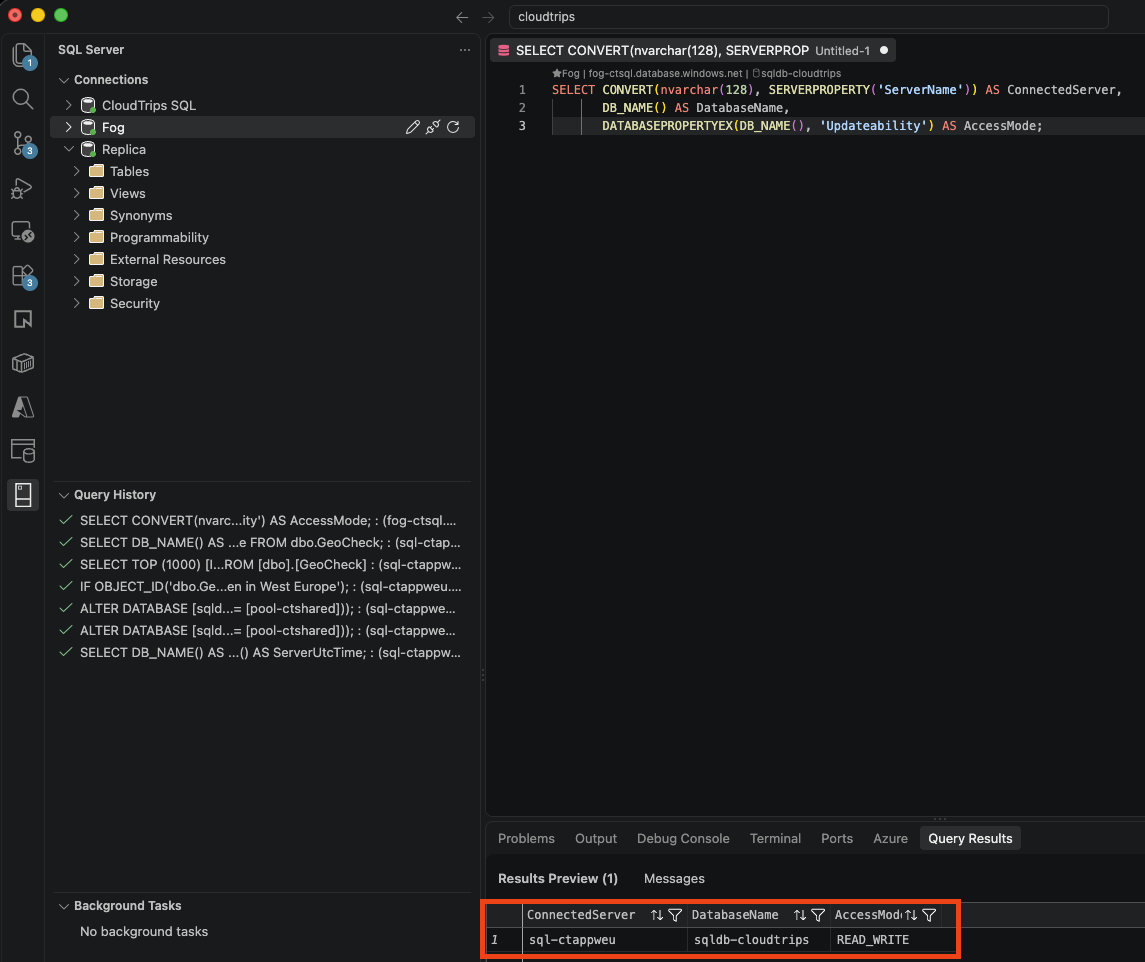
Erwarte den aktuellen primären Server sql-ctappweu, Datenbank sqldb-cloudtrips und READ_WRITE. Deine Anwendung sollte die Listeneradresse verwenden.
Geplantes Failover testen
Öffne bei gesunden Datenbanken die Gruppenseite, wähle Failover und bestätige den geplanten Vorgang. Er synchronisiert zuerst die Daten, wechselt dann die Rollen und trennt vorhandene Sitzungen.
Warte, bis sql-ctappfrc primär ist. Verbinde dich erneut über dieselbe Listeneradresse und wiederhole die obige Abfrage.
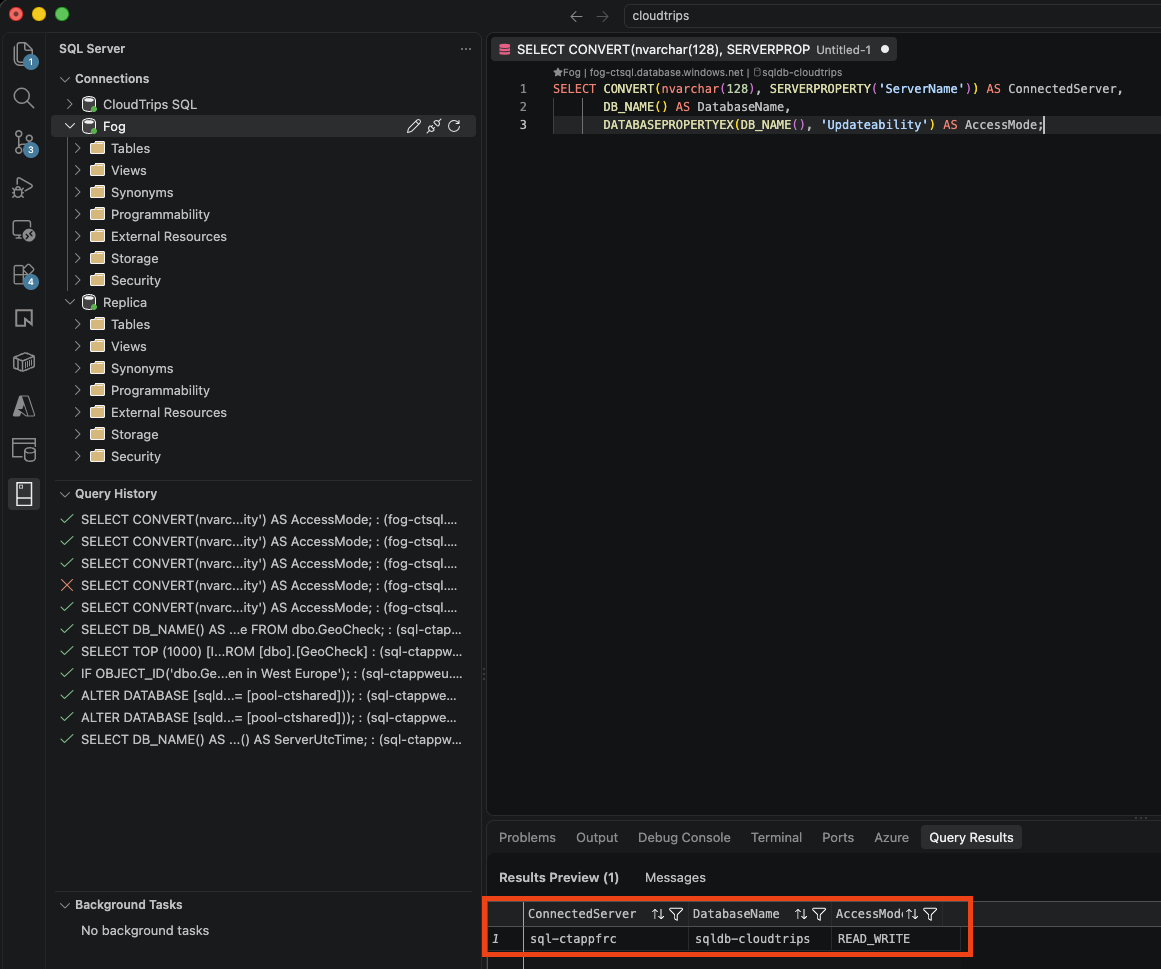
Erwarte sql-ctappfrc und READ_WRITE. Der Server hat gewechselt, deine Verbindungsadresse bleibt gleich. DNS-Aktualisierungen und Neuverbindungen brauchen Zeit; Anwendungen benötigen Wiederholungslogik. Das testet einen geplanten Rollenwechsel; der Microsoft-managed-Auslöser für regionale Ausfälle bleibt ungetestet.
Zurückwechseln oder bereinigen
Wähle nach Wiederherstellung einer gesunden Replikation erneut Failover, um die primäre Rolle nach West Europe zurückzugeben. Behalte das Paar für weitere Labs oder lösche die Failovergruppe, beende die verbleibende Georeplikation und lösche rg-cloudtrips-sql-dr-frc. Das Löschen der Gruppe erhält Datenbanken und Replikation. Lösche nach Abschluss auch die Labressourcen der primären Datenbank; erhaltene Datenbanken bleiben kostenpflichtig.